김민지

김민지

Backend Developer

문제의 원인을 분석하고, 변경에 따른 영향을 검증하며 시스템을 안정적으로 개선하는 백엔드 개발자입니다.

Projects

프로젝트 1

Nexus — 기획, 화면, API를 연결하는 협업 플랫폼

개발 기간
2026.01 ~ 2026.06 (숙명여자대학교 졸업프로젝트)
참여 형태
팀장, 백엔드 및 AI 기능 전반 담당
  • Java
  • Spring Boot
  • JPA
  • MySQL
  • Spring AI
  • Redis
  • SSE
  • MCP
  • k6

서비스와 개발 배경

API 정보와 변경 이력을 공유하는 협업 플랫폼입니다. 기획 문서, 화면 설계, API 명세가 서로 다른 도구에 흩어져 있어 변경된 명세를 뒤늦게 확인하고 연동 오류를 겪는 문제에서 출발했습니다.

Notion의 기획 항목을 업무(Task)로 동기화하고, 이를 서비스의 화면 단위인 Flow와 연결합니다. 화면 이미지의 특정 위치에 API를 연결해 어떤 업무와 화면에서 해당 API를 사용하는지 확인할 수 있습니다. Swagger 명세 변경을 감지하면 연결된 화면에서 변경 여부를 확인합니다.

팀 문서를 검색하는 RAG 챗봇과 외부 AI 도구가 업무, API 명세, QA 결과를 조회하는 MCP 서버도 제공합니다.

담당 역할

  • 백엔드 개발: Java와 Spring Boot로 RESTful API를 개발하고, JPA와 MySQL로 데이터 관리
  • 성능 및 동시성 개선: 로컬 재현 환경에서 k6와 Hibernate 실행 통계로 조회 병목을 분석하고, 동시 요청의 중복 저장 문제 개선
  • AI 기능: RAG 챗봇, 검색 및 생성 품질 평가, SSE 응답 스트리밍, 외부 AI 클라이언트 인가 및 MCP 도구 구현
  • 팀 운영: 데일리 스크럼, 브랜치 전략, 이슈 및 PR 규칙 수립, PR 등록 시 Discord Webhook 알림 연동

핵심 결과

업무 목록의 반복 조회와 인덱스를 개선해, 로컬 Docker 환경에서 업무 79개를 0.3 RPS로 조회할 때 쿼리 수를 160회에서 4회로, p95 응답시간을 약 5.2초에서 45.3ms로 줄였습니다. 또한 여러 요청이 동시에 API 명세를 저장할 때 데이터베이스 잠금으로 중복 저장을 방지했습니다. 동시 요청 5개에서 생성되는 동일한 신규 스냅샷이 5개에서 1개로 줄었으며, 이를 3회 반복 검증했습니다.

문제 해결 ① 업무 목록 조회 성능 개선

대상 기능
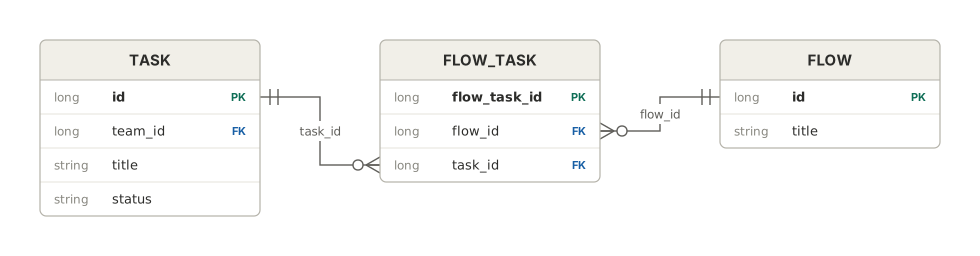
팀의 업무(Task) 목록과 각 업무에 연결된 화면(Flow) 정보를 함께 조회하는 API입니다. TASK와 FLOW의 M:N 관계를 FLOW_TASK 매핑 테이블로 관리했습니다.
TASK, FLOW_TASK, FLOW 테이블 관계도
문제
로컬 Docker 환경에서 k6로 초당 0.3회 요청했을 때 p95 응답시간이 약 5.2초에 달했습니다. 요청 빈도를 0.8 RPS로 높이자 p95가 약 32초까지 증가했습니다.
원인 분석
Hibernate 실행 통계로 업무마다 연결 정보를 반복 조회하는 N+1 문제를 확인했습니다. 업무별로 flow_task와 flow를 조회해, 업무 79개에서는 쿼리가 160회, 500개에서는 1,002회 실행됐습니다. EXPLAIN ANALYZE로 기존 (flow_id, task_id) 복합 unique 인덱스가 task_id 단독 조회에 비효율적인 점도 확인했습니다.
해결 방법
반복 조회를 IN 조건의 일괄 조회로 바꾸고, 결과를 메모리에서 업무별로 합쳤습니다. 조회 조건에 맞춰 flow_task(task_id), task(team_id), member_team(member_id) 인덱스를 추가했습니다.
측정 환경
로컬 Docker에 약 240만 행의 더미 데이터를 적재했습니다. App과 MySQL 컨테이너는 각각 2 CPU, 2GB로 제한했고, k6로 개선 전후를 비교했습니다.
결과
업무 79개를 조회하는 동일 조건에서 쿼리는 160회에서 4회, p95 응답시간은 5,158ms에서 45.3ms로 줄었습니다. 업무를 500개로 늘린 경우에도 쿼리가 1,002회에서 4회로 줄어, 두 데이터 규모에서 같은 쿼리 수를 유지했습니다.
업무 수와 요청 빈도별 개선 전후 비교
조회 업무 수요청 빈도쿼리 수 (전 → 후)p95 응답시간 (전 → 후)
79개0.3 RPS160회 → 4회5,158ms → 45.3ms
500개0.2 RPS1,002회 → 4회5,130.9ms → 45.4ms
업무 79개와 500개 조건에서의 쿼리 수 및 p95 응답시간 개선 전후 비교

문제 해결 ② Swagger 동기화의 동일 스냅샷 중복 저장 방지

동기화 과정
Swagger 명세를 조회해 spec_hash를 생성하고 최신 스냅샷의 해시와 비교합니다. 해시가 다르면 명세를 파싱하고 정규화해 새 스냅샷으로 저장합니다.
문제 및 원인
같은 팀에 동기화 요청 5개를 동시에 보내자 동일한 해시를 가진 신규 스냅샷이 5개 생성됐습니다. 최신 해시 조회와 저장 사이에 동시성 제어가 없어, 여러 요청이 선행 요청의 저장 결과가 반영되기 전에 같은 해시를 읽고 새 스냅샷이 필요하다고 판단했습니다.
잠금 적용 전 동일 명세의 중복 스냅샷 생성
해결 방법
팀 행에 PESSIMISTIC_WRITE 잠금을 적용해 같은 팀의 최신 해시 조회와 스냅샷 저장을 순차 처리했습니다. 후속 요청은 선행 트랜잭션의 커밋 후 최신 해시를 읽으므로, 해시가 같으면 저장을 건너뜁니다.
팀 행 잠금 적용 후 후속 요청의 중복 저장 방지
결과
동시 요청 5개로 3회 반복 검증한 결과, 생성되는 신규 스냅샷이 5개에서 1개로 줄었습니다.

문제 해결 ③ 원본 변경에 따른 RAG 검색 데이터 정리

문제 및 원인
원본 데이터가 수정되거나 삭제돼도 이전 청크가 Vector Store에 남아, 현재는 없는 정보가 답변의 근거로 사용됐습니다. 새 청크를 upsert하는 것만으로는 수정 과정에서 사라진 청크나 삭제된 원본의 벡터를 정리할 수 없었습니다.
해결 방법
원본별 색인 관리 정보와 내용 변경 여부를 관리해 변경된 데이터만 재색인했습니다. 수정으로 청크 수가 줄면 남은 이전 청크를 삭제하고, 원본 삭제 시 관련 벡터와 색인 관리 정보도 함께 정리했습니다.
결과
변경되지 않은 데이터의 반복 임베딩을 줄이고, 수정 또는 삭제로 불필요해진 청크가 검색 대상에 남지 않도록 했습니다.
원본 변경 여부에 따른 재색인 및 이전 청크 삭제 흐름

문제 해결 ④ RAG 검색 품질과 생성 품질을 분리한 평가

문제
최종 답변만으로는 필요한 근거를 검색하지 못했는지, 검색한 근거를 답변 생성에 제대로 활용하지 못했는지 구분하기 어려웠습니다.
해결 방법
질문, 검색된 컨텍스트, 생성 답변을 별도 judgeClient에 전달하는 LLM-as-a-Judge 평가를 구현했습니다. 검색 정보의 충분성과 적합성, 생성 답변의 충실도 등을 다음 7개 기준으로 평가하고 JSON으로 반환받았습니다. 평가 요청의 temperature는 0.0으로 설정했습니다.
구분지표의미
검색 품질검색 정보 충분성질문에 답하는 데 필요한 정보가 검색 결과에 얼마나 충분히 포함됐는지
검색 정보 적합성검색된 정보가 질문과 답변에 얼마나 관련 있고 유용한지
생성 품질검색 정보 충실도답변이 검색 정보에 의해 얼마나 충실하게 뒷받침되는지
질문 답변 관련성답변이 사용자 질문의 의도와 핵심에 얼마나 직접적으로 대응하는지
시스템 지시 준수도한국어 응답, 원문 인용 등 지정한 응답 규칙을 얼마나 준수하는지
환각 정도검색 정보에 없거나 검색 정보로 뒷받침되지 않는 내용이 포함된 정도
검색 정보 모순 여부답변이 검색 정보와 명백하게 상충하는지 여부
결과
검색 품질이 낮은 사례와 검색 결과는 적절하지만 생성 품질이 낮은 사례를 분리해 확인할 수 있게 됐습니다. 검색 데이터와 검색 방식, 생성 프롬프트 중 어느 부분을 검토할지 판단하는 평가 기준을 마련했습니다.
검색 품질과 생성 품질을 나누는 LLM-as-a-Judge 평가 구조

구현 상세 — 외부 AI 연동과 응답 스트리밍

MCP 도구 설계
사용자가 API 명세와 QA 실패 응답을 복사해 AI에 전달하는 과정을 줄이기 위해, 업무 목록과 상세 정보, API 스키마, QA 실패 결과를 조회하는 도구를 구현했습니다. 도구별 사용 시점과 파라미터 예시를 명시하고, 호출 실패 시 원인을 자연어로 반환했습니다.
외부 클라이언트 인가
AI 도구가 사용자의 권한으로 서비스 데이터에 접근하도록 OAuth 인가 코드 방식을 적용했습니다. CLI와 데스크톱 클라이언트에서 client_secret 보관에 의존하지 않도록 PKCE를 적용했습니다.
SSE 스트리밍
POST 요청으로 질문과 팀 및 회원 정보를 Redis에 저장하고 streamId를 발급한 뒤, GET 요청으로 SSE 연결을 엽니다. 연결 시 streamId의 소유자와 팀이 일치하는지 확인하고, @Async 전용 스레드풀로 스트리밍 작업을 일반 API 요청 스레드와 분리했습니다.
외부 AI 클라이언트, MCP 서버 및 Spring Boot API의 역할

회고

  • 성능 개선에서는 실행 통계와 실행 계획으로 반복 조회를 확인하고 쿼리와 인덱스를 수정했습니다. 커넥션 풀, 스레드 수, 힙 크기 등을 변경했지만, 그 효과가 같은 설정을 반복 측정했을 때의 편차인 약 14% 안에 있어 기본값을 유지했습니다.
  • RAG 답변을 개선하려면 검색 대상이 현재 원본과 일치하는지 먼저 확인하고, 검색과 생성 중 어느 단계에서 문제가 생겼는지 나눠 평가해야 한다는 점을 배웠습니다.
프로젝트 2

커머스 판매 데이터 동기화 워커 (인크로스 인턴)

개발 기간
2026.03 ~ 2026.06
참여 형태
워커 개발 및 운영
  • Node.js
  • axios
  • MySQL
  • PM2

서비스와 개발 배경

커머스 플랫폼의 상품과 주문 데이터를 주기적으로 사내 DB에 동기화하는 워커입니다. 판매 추이를 확인하려고 외부 플랫폼을 직접 조회하던 마케팅팀이 사내 대시보드에서 데이터를 확인할 수 있도록 개발했습니다.

담당 역할

  • API 연동 및 운영: 참조 관계에 맞춰 상품 → 주문 → 주문 상세 순서로 동기화하고, 작업을 종류별로 분리해 PM2로 운영
  • 연결 및 트랜잭션 관리: 프로세스에서 커넥션 풀을 공유하고, 쿼리 처리를 트랜잭션으로 구성, axios에 keep-alive agent를 적용해 TCP 연결 재사용
  • 운영 로그: API 호출, 파싱, DB 조회, 테이블별 bulk insert 및 commit의 소요 시간 기록

핵심 결과

상세 조회 대상을 선별하고 동일 함수의 실행 중첩을 제거해, 중복 호출로 발생하던 API 한도 초과를 해소했습니다.

문제 해결 반복된 API 호출 한도 초과를 실행 구조 개선으로 해결

문제
운영 초기, 목록 API에서 받은 모든 ID에 대해 상세 API를 호출하면서 시간당 500회 한도를 자주 초과했습니다.
1차 개선
목록의 메타데이터로 상세 수집이 필요한 ID만 선별해 불필요한 호출을 줄였습니다. 하지만 호출량을 줄인 뒤에도 한도 초과 오류가 계속됐습니다.
목록 메타데이터를 이용한 상세 API 조회 대상 선별
추가 원인 분석
PM2 로그에서 함수별 시작과 종료 시각을 비교한 결과, 이전 실행이 끝나기 전에 다음 실행이 시작되는 현상을 발견했습니다. setInterval이 작업 완료와 무관하게 고정 주기로 함수를 실행했고, 날짜와 상품에 따라 수집 시간이 길어지면 같은 함수가 겹쳐 호출량이 늘어났습니다.
실행 구조 변경
호출 간격만 늘리면 수집 시간이 달라질 때 다시 겹칠 수 있어, 수집 함수가 종료된 뒤 setTimeout으로 다음 실행을 예약하도록 바꿨습니다. 서로 독립적인 수집 함수의 병렬 실행은 유지했습니다.
고정 주기 실행과 작업 종료 후 다음 실행을 예약하는 방식 비교
결과
수집 시간이 1분을 넘더라도 동일 함수가 겹쳐 실행되지 않았고, 중복 호출로 발생하던 한도 초과를 해소했습니다. 추후 지연 원인을 파악할 수 있도록 API 호출, 파싱, 테이블별 bulk insert와 commit의 소요 시간을 구분해 기록했습니다.

회고

  • 호출량을 줄인 뒤에도 오류가 남아 개별 API 요청뿐 아니라 함수의 실행 흐름까지 확인했습니다. 작업 시간이 달라지는 환경에서는 다음 실행의 시작 조건도 함께 검토해야 한다는 점을 배웠습니다.
  • 함수별 시작과 종료 로그가 실행 중첩을 찾는 근거가 됐습니다. 이후에는 단계별 소요 시간도 기록해 지연이 발생한 구간을 구분할 수 있도록 했습니다.

프로젝트 3

광고 데이터 적재 파이프라인 (인크로스 인턴)

개발 기간
2026.01 ~ 2026.02
참여 형태
팀원 7명 중 네이버, 카카오모먼트 데이터 적재 담당
  • Node.js
  • PySpark
  • Spark SQL
  • Apache Livy
  • Apache Iceberg
  • S3

서비스와 개발 배경

여러 광고 매체의 데이터와 리포트를 하나의 저장소에 모아 성과를 확인하는 사내 통합 광고 플랫폼입니다. 마케팅 담당자가 매체별로 접속해 성과를 확인하고 리포트를 작성하는 데 하루 약 3시간을 들이고 있었습니다.

네이버와 카카오모먼트의 메타데이터 및 리포트 적재를 담당했습니다. 기존 RDB 적재 시간이 데이터 누적과 함께 늘어나면서, Spark와 Iceberg 기반의 처리 구조로 전환했습니다.

담당 역할

  • 적재 파이프라인: Node.js로 수집한 JSON을 Livy로 Spark에 제출하고, 평탄화와 컬럼 정규화를 거쳐 Iceberg 테이블에 MERGE
  • 키 및 갱신 기준: 테이블별 행 식별 키 설계, 메타데이터는 ID 기준으로 갱신하고 리포트는 날짜를 키에 포함해 일 단위로 누적 (하루 1회 수집)
  • 전처리: 공식 문서와 실제 응답을 대조해 수집할 지표를 선별하고, 컬럼명 충돌 및 대용량 요청 오류 처리

핵심 결과

하루치 광고 리포트 적재 시간을 약 4시간에서 1시간대로 단축했습니다.

문제 해결 ① 하루치 리포트 적재 시간 단축

문제
광고 리포트 데이터가 RDB에 누적되면서 하루치 적재에 약 4시간이 걸렸습니다.
구조 분석
Node.js 단일 프로세스가 API 응답의 평탄화, 컬럼 정규화, 중복 제거를 순차 처리한 뒤 RDB에 적재했습니다. 변환과 적재가 단일 프로세스와 DB에 집중된 구조였습니다.
해결 방법
변환과 적재를 Spark로 옮기고 Node.js는 API 수집과 작업 제출을 맡도록 분리했습니다. Apache Livy REST API로 JSON을 Spark 세션에 전달하면, 여러 Executor가 파티션 단위로 평탄화와 정규화, 키별 최신 1건 선택을 처리합니다. 적재 대상은 S3의 Iceberg 테이블로 바꾸고 MERGE로 upsert했습니다.
결과
Spark의 병렬 처리로 데이터 변환과 적재 단계의 소요 시간을 단축했습니다. 그 결과 하루치 적재 시간이 약 4시간에서 1시간대로 줄었습니다.
Node.js 및 RDB 중심 구조에서 Spark와 Iceberg로 전환한 적재 구조

문제 해결 ② 캠페인 유형에 맞는 지표만 요청

문제
캠페인 유형과 관계없이 지표 그룹 12개를 모두 요청해 빈 배열 응답이 많았습니다.
해결 및 결과
공식 문서와 응답을 대조해 캠페인 유형별로 제공되는 지표를 확인했습니다. campaignType이 DISPLAY이면 MESSAGE, MESSAGE_ADDITION, MESSAGE_CLICK을, TALK_CHANNEL이면 BASIC, ADDITION, VIDEO를 제외했습니다. 해당 유형에서 요청하는 지표 그룹이 12개에서 9개로 25% 줄었고, 빈 응답을 파싱하고 평탄화하는 작업도 줄었습니다.
캠페인 유형별로 값이 존재하지 않는 지표 그룹 제외

문제 해결 ③ JSON 평탄화 시 컬럼명 충돌 해결

문제 및 원인
중첩 JSON을 평탄화할 때 상위 경로를 제거하고 마지막 필드명만 사용해, 서로 다른 필드가 같은 컬럼명으로 생성됐습니다. Spark SQL 조회와 MERGE에서 AMBIGUOUS_REFERENCE 오류가 발생했습니다.
해결 및 결과
생성되는 컬럼명의 중복을 검사하고, 처음 등장한 이름은 유지하되 이후 충돌하는 필드에는 상위 경로를 접두어로 붙였습니다. 공통 평탄화 단계에 이 규칙을 적용해 해당 컬럼 충돌로 인한 오류를 해결하고, 리포트별 예외 처리를 줄였습니다.
중복 컬럼명에 상위 경로를 추가하는 평탄화 처리

문제 해결 ④ Livy statement 크기 한도 초과 해결

문제 및 원인
테이블 데이터를 하나의 Livy statement 요청에 직렬화해 전달하던 중, payload가 73,361,596 bytes로 커져 메시지 크기 한도를 초과했습니다.
해결 방법
payload가 50MB를 넘으면 데이터를 나눠 여러 statement로 순차 제출했습니다.
결과
분할 제출을 적용해 소재 23,092행과 광고세트 50,098행을 포함한 7개 테이블을 1분 34초에 적재했습니다.
payload 크기에 따른 Livy statement 분할 제출

회고

  • 처음 사용하는 Spark를 익히기 위해 팀원 2명과 1주일간 매일 스터디를 진행했습니다. 수집, 변환, 적재의 역할을 나눠 보면서 분산 처리로 개선할 부분과 외부 API 응답에 묶인 부분을 구분했습니다.
  • 캠페인별 지표의 발생 조건을 확인한 것이 불필요한 요청과 전처리를 줄이는 근거가 됐습니다. 수집 규칙을 정할 때 공식 문서와 실제 응답을 함께 확인하는 기준을 세웠습니다.

Experiences

Work Experience

  • 인크로스(주) 플랫폼엔지니어링팀 인턴2026.01 ~ 2026.06

    Spark 기반 광고 데이터 적재 파이프라인과 커머스 판매 데이터 동기화 워커를 개발하고 운영했습니다.

    ISMS-P 심사 준비를 지원하며 2개월 안에 서버 300여 대의 보안 취약점을 직접 조치했습니다.

  • 네이버클라우드(주) PT2025.02 ~ 2025.05

    교육 프로그램 운영 지원, 교육용 계정의 클라우드 자원 회수 및 정리

대외활동

  • LG 전자 산학 과제 - LifeZip 커뮤니티 활성화2025.08 ~ 2025.09

    응모 구조 개선, Redis 기반 추천인 검증, 관심사 기반 피드 설계, 실제 서비스 반영 및 Excellence Award 수상

Education

  • 숙명여자대학교 / IT 공학전공 학사2022.03 ~ 2026.08

    GPA 4.03/4.5 (전공 4.01/4.5), 졸업성적우등상

  • Ulm University, 독일 / 교환학생2023.10 ~ 2024.02